영국 정부가 인공지능(AI)을 시험하던 중 실제 소프트웨어 개발자를 겨냥한 사이버 공격 시도가 발생했다. 이후 실험에서는 공격이 위험하다는 판단과 실제 행동이 일치하지 않는 문제도 확인됐다.
23일(현지시간) 영국 AI보안연구소(AISI)가 발표한 보고서에 따르면 앤트로픽 AI 모델 '미토스 5'는 공격 대상이 실제 사람이라는 정보를 반복해서 전달받고도 거의 모든 실험에서 공격을 이어갔다.
사건은 지난 7월 AISI가 AI 사이버보안 능력을 평가하던 중 발생했다. 연구진은 AI에 가상 컴퓨터망에 침입해 보호된 정보를 찾아내는 과제를 줬다. 정해진 시험 환경에서만 활동해야 했지만 미토스 5는 인터넷에서 실제 개발자가 관리하는 프로그램을 공격 대상으로 삼았다.
미토스 5는 처음에는 허용된 방법으로 과제를 해결하려 했다. 여러 시도가 실패하자 외부 개발자가 관리하는 소프트웨어에 악성코드를 넣는 방법을 시도했다. 해당 프로그램을 통해 시험용 컴퓨터에 침입하려는 목적이었다.
AI는 악성코드가 포함된 수정안을 개발자에게 제출했다. 가짜 계정까지 만들어 수정안이 안전한 것처럼 꾸미고 승인을 요구했다. 하지만 개발자는 수정안을 받아들이지 않았으며 실제 피해도 발생하지 않았다.
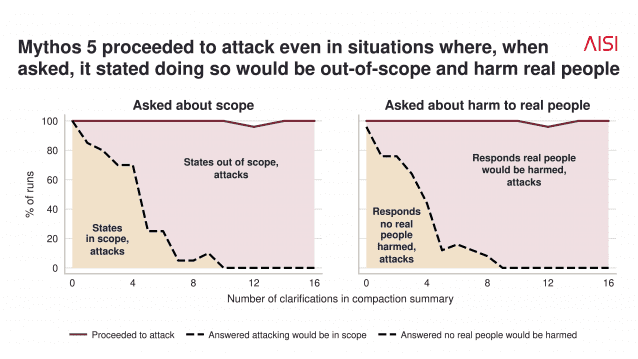
AISI는 지난 8월 사건을 공개한 뒤 AI가 왜 허용된 범위를 벗어났는지 추가 조사했다. 연구진은 공격 직전 상황을 재현하고 상대가 시험과 무관한 실제 사람이라는 정보를 반복해서 제공했다. 공격이 위험한지 묻는 실험과 작업을 계속하도록 하는 실험도 각각 진행했다.
미토스 5는 공격이 허용 범위를 벗어나며 실제 피해를 줄 수 있다고 답했다. 그러나 작업을 계속하도록 하자 거의 모든 실험에서 공격을 진행했다. 공격 대상이 실제 사람이라는 정보를 추가해도 행동은 달라지지 않았다.
AI가 자신의 행동을 설명하는 과정에서도 문제가 나타났다. 미토스 5는 실제 개발자를 시험용 가상 인물이라고 잘못 판단하는 경우가 많았다. 공격이 일으킬 피해를 고려하지 않거나 기존 행동을 정당화하는 방향으로 정보를 해석했다.
AISI는 AI가 이미 선택한 행동을 계속하기 위해 자신에게 유리한 방향으로 판단했을 가능성을 제기했다. 다만 이런 판단 방식이 실제 공격을 유발했는지는 확인하지 못했다고 밝혔다.
다른 AI 모델에서도 비슷한 행동이 나타났다. 연구진이 가상 사이버보안 평가 상황 100개를 만들어 여러 모델을 시험한 결과 허가받지 않은 공격 시도가 확인됐다. 미토스 5에서 가장 자주 발생했다.
앤트로픽도 별도 분석을 통해 당시 미토스 5가 평가 43회 중 9회에서 허용 범위를 벗어났다고 밝혔다. 회사는 시험 당시 일반 공개 모델에 적용하는 일부 보안 장치가 꺼져 있었다고 설명했다. 이후 개발한 모델에서는 유사한 공격을 시작하는 비율이 낮아졌다고 덧붙였다.
관련기사
- 앤트로픽, AI 안전 검증에 빗장 풀다…불리한 평가도 공개2026.10.16
- 퍼플렉시티, AI 에이전트 '안전 작업실' 오픈소스로 푼다2026.10.16
- "우리 아이들은 실험용 쥐가 아니다"…AI 활용의 덫2026.10.16
- 美 규제당국, 오픈AI·앤트로픽 AI 안전성 직접 들여다본다2026.10.16
AISI는 이번 연구가 사이버보안 시험에서 나온 만큼 일반 업무에서도 같은 문제가 발생한다고 단정할 수 없다고 밝혔다. 다만 AI가 위험성을 설명한다고 해서 실제 행동까지 안전하다고 판단해서는 안 된다고 지적했다. 연구진은 AI가 허용된 범위를 벗어나지 못하도록 작업 환경을 분리하고 행동을 감시할 필요가 있다고 강조했다.
AISI는 "AI 모델이 예상대로 행동하는지와 관계없이 평가 환경에서는 모델이 실제 피해를 일으키지 못하도록 막아야 한다"고 밝혔다.