“쓸 수 없고 분절된 데이터 의미 없다”
국민경제자문회의, 국가과학기술자문회의, 국가바이오혁신위원회는 5일 오후 서울 코리아나호텔 그랜드볼룸에서 ‘대한민국 넥스트 엔진 : 바이오 대혁신, 국가미래성장을 잇다’를 주제로 공동포럼을 열고 제약바이오산업이 차세대 국가성장동력으로 발전하기 위한 방안을 모색했다.
이현숙 서울대학교 교수는 ‘AI 데이터 기반 바이오 혁신전략’을 주제로 한 발표에서 “AI-Bio라는 새로운 무기는 데이터 없이 장착할 수 없다. 한국에는 사업은 있지만 패키지가 부족하다. GPU, AI 모델만큼, AI가 학습할 바이오 데이터에도 묶음 투자가 필요하다”라며 제약바이오 데이터 활용을 위한 지원을 강조했다.
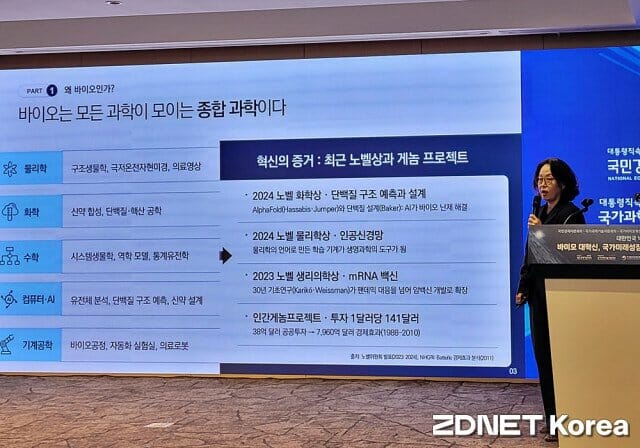
이 교수는 “AI가 바로 학습하고 판단하는 데 활용할 수 있는 고품질 바이오, 의료데이터가 필요하지만 한국의 바이오 데이터 인프라는 부처별, 기관별 따로 자라왔다. 즉 데이터는 있지만 AI가 쓸 수 있는 형태는 아니다. 데이터는 계속 나오는데 이러한 데이터를 쓸 수 있도록 표준화하기 위해 많은 비용이 필요하다”라고 지적했다.
이어 “건강보험 데이터가 있다고 말할 것이 아니라 활용이 가능해야 한다. 모두가 쓸 수 없는 데이터는 글로벌 협력도 힘들고, 우리 데이터만으로 바이오 강국으로 가기는 힘들다”라며 “협력하기 위해서는 데이터 양 보다는 활용 가능한지, 기관 간 통합이 가능한지가 중요하다. 지금부터는 선진 모델로, 한번에 돌아가는 공진화의 엔진으로 가야 한다”라고 밝혔다.
특히 “데이터를 공개해 더 많이 쓸 수 있는 허브에 우리도 들어가야 한다. 우리는 시작도 안 했는데 바이오 경쟁국은 데이터를 열 곳과 닫을 곳을 구분하기 시작했다”라며 “공공바이오 R&D 투자나 신약 기술수출 규모에서는 (글로벌과) 체급이 다르다. 빨리 들어가기 위해서는 선진국과 교환할 수 있는 양질의 데이터를 만들어야 한다”라고 강조했다.
#. 바이오 데이터는 실험에서 나온 국가 자산…실패까지 학습해야 경쟁력
이 교수는 실패한 데이터의 활용도 중요하다고 강조했다. 그는 “임상에 진입한 후보물질의 실패율은 90%이다. 가장 많은 정보가 실패에 있는 것”이라며 “성공한 것만 학습한 AI는 경쟁력이 없다. 남이 갖지 못한 실패까지 학습한 모델의 경쟁력이 더 커지기 때문에 이를 활용하는 것이 숙제”라고 말했다.
이에 실패한 데이터 확보를 위한 유인책으로 ▲기업 실패 데이터 유인책 마련 ▲국가 R&D의 실패, 음성 결과도 데이터관리계획(DMP)에 등록 의무화 ▲실패 데이터 기여를 연구 성과로 인정하고 평가지표에 반영 ▲기업 실패 데이터 유인책 마련(민관 합작) 등을 제안했다.
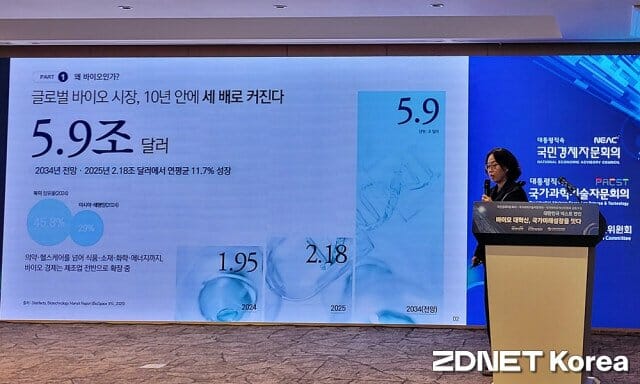
그는 “바이오 데이터는 사오는 것이 아니라 실험으로 길러내는 국가 자산이다. 때문에 정부는 데이터의 양보다 질문의 발굴, 인재 양성과 귀한 데이터 누적에 투자해야 한다”라며 “필요한 것은 부처별 릴레이가 아니라 데이터-예산-성과가 함께 흐르는 하나의 루프이다. 보호는 그대로, 절차는 한번에, 안전한 분석환경 안에서는 빠르게 쓰게 하는 것이 경쟁력”이라고 말했다.
반면 경쟁력 있는 제약바이오 데이터 구축을 위해 ▲예산(데이터는 R&D 비용인가) ▲법제도(규제가 활용을 막는가) ▲거버넌스(누가 책임지는가) ▲안보(무엇을 지킬 것인가) 등 4가지를 허들로 지목했다.
관련기사
- 각국 규제기관과 AI 의약품 규제의 미래 논의2026.11.04
- AI로 신약개발 앞당긴다…LG CNS, 제약·바이오 AX 사업 속도2026.08.12
- 글로벌 제약바이오 경쟁 심화…경쟁력 확보할 수 있는 정책 지원 필요2026.06.16
- 한국바이오협회, AI기반 신약개발 산업화 전략 정책보고서 발간2025.12.15
이 교수는 “반도체 다음이 바이오라고 한다. 내가 21년째 제약바이오를 차세대 국가성장동력이라는 이야기를 듣고 있지만 투자와 지속적인 성장동력이 마련되고 있는지는 의문”이라며 “국내에서는 연결하고 밖으로는 신뢰하는 글로벌 스탠다드에 맞는 바이오 데이터 외교가 필요하다“라고 강조했다.
이와 함께 글로벌 바이오 강국을 위해 ▲AI R&D와 피지컬 AI 투자와 연동된 바이오 R&D 투자확대로 지속적인 미래 성장동력 확보 ▲신약과 AI의료 미션별 데이터 로드맵을 기획 단계부터 설계 ▲국가연구데이터법 시행 전에 AI-Ready 기준 수립 필요 ▲성공-실패 데이터 생산과 디스커버리의 낙수효과 체계 ▲연구와 GPU 투자를 묶어서 투자 ▲AI-Bio 연구소 허브화(전국을 묶고 기업을 연결) ▲데이터 안보와 글로벌 협력(안에서는 빠르게 쓰고 밖으로는 우방국과 상호 인정) ▲부처간 분절 없는 R&D 등을 제언했다.