"현재 다수 인공지능(AI) 벤치마크는 10~20개 언어로만 모델을 평가하고 있습니다. AI의 실제 역량을 제대로 검증하려면 소수 언어·문화 중심 평가 평가 체계부터 바꿔야 합니다. 현지 전문가와 함께 각 지역 언어와 문화를 벤치마크에 반영해 모델이 소수 국가의 사회 관습과 규범까지 이해하는지 평가해야 할 것입니다."
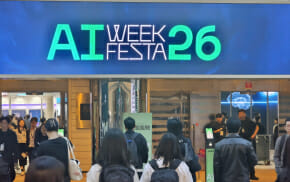
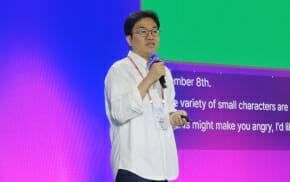
로라 아로요 구글딥마인드 수석 과학자는 6일 서울 코엑스에서 열린 'AI페스타 2026' 기조연설에서 벤치마크 평가 방식이 이같이 개편돼야 한다고 주장했다. 다국어·다문화 AI 평가를 주제로 한 발표에서 기존 벤치마크의 영어 편중 문제와 개선 과제를 제시했다.
아로요 박사는 다양한 언어와 문화적 맥락에서 AI 모델 안전성과 응답 적절성을 평가하는 연구를 진행하고 있다. 지역별 가치관과 사회 규범을 데이터 수집과 모델 평가에 반영해 영어 중심 AI 평가 한계를 줄이는 데 주력하고 있다.
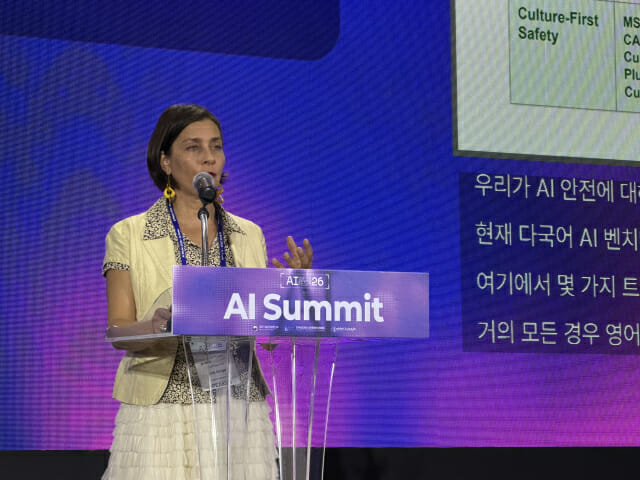
아로요 박사는 현재 AI 모델이 약 70~100개 언어를 지원하지만 다수 벤치마크는 10~20개 언어 능력만 평가한다고 지작했다. 지구상에 약 7000개 언어가 존재한다는 점을 고려하면 평가 범위가 제한적이라는 설명이다.
그는 "현존하는 벤치마크 평가 문항을 만드는 방식에 한계가 있다"며 "영어로 작성한 문항을 다른 언어로 번역하면 질문에 담긴 상황은 전달할 수 있지만 현지 문화적 배경이나 사회적 의미까지 충분히 반영하기 어렵다"고 말했다.
그러면서 "현재 거의 모든 평가가 영어에서 출발한다"며 "영어 자료를 번역하는 것과 처음부터 해당 지역의 언어로 평가 자료를 만드는 것은 같지 않다"고 덧붙였다.
그는 모델의 텍스트뿐 아니라 이미지 이해 능력도 함께 점검돼야 한다고 강조했다. 이미지에는 글로 명확히 설명되지 않은 지역적 맥락이 담겨 있어 모델이 문화적 의미를 잘못 해석할 가능성이 있기 때문이다.
그는 "앞으로 모델은 각 지역 전통과 사회 규범, 법률뿐 아니라 높임말과 관용 표현, 방언 등을 평가 자료와 기준에 반영해야 한다"고 강조했다.
아로요 박사는 평가에 참여하는 사람의 구성도 중요하다고 주장했다. 데이터 수집과 평가 과정에 다양한 문화적 배경을 가진 사람들을 참여시켜야 한다는 설명이다.
그는 "벤치마크 평가는 특정 지역이나 집단 관점에 치우쳐선 안 된다"며 "평가 대상을 늘리는 과정에서도 지역 고유의 의미와 차이를 유지해야 한다"고 말했다.
"벤치마크 범위 확대 필요…안전성·문화적 적절성 구분돼야"
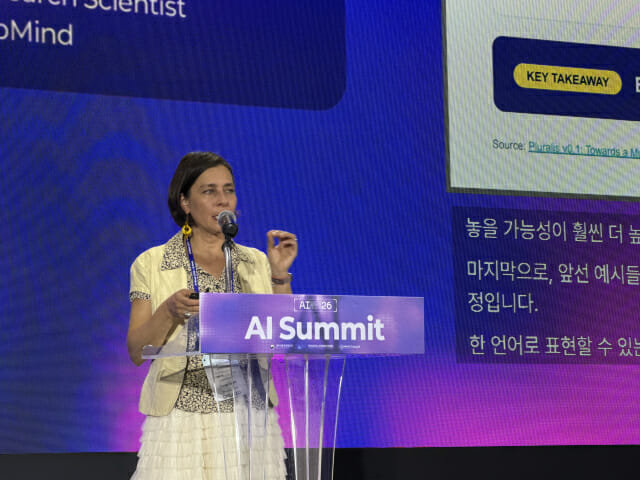
아로요 박사는 벤치마크 평가 범위를 챗봇을 넘어 AI 에이전트와 피지컬 AI로 확대할 필요가 있다고 밝혔다. 거대언어모델(LLM)을 평가 수단으로 활용할 때도 소수 집단과 지역 관점을 충실히 반영하는지 검증해야 한다고 재차 당부했다.
그는 AI의 언어적 유창함을 문화 이해 능력과 동일하게 봐서는 안 된다고 강조했다. 한국어를 자연스럽게 구사하는 모델이라도 높임말 체계를 제대로 따르지 못하거나 현지 관습에 어긋나는 답변을 할 수 있다는 설명이다.
관련기사
- 세라젬, 코엑스 'AI 페스타 2026'서 헬스케어 체험 휴게존 운영2026.10.06
- [ZD브리핑] 'AI 페스타 26' 개막…국감·삼성전자 실적도 주목2026.10.05
- 6만명 몰린 AI축제, 더 커져 돌아왔다…'AI페스타26' 6일 개막2026.10.05
- "데이터 플랫폼 기업 도약"...크리니티, 'AI페스타 2026'서 AI 워크OS '써팀' 선보여2026.10.04
이에 따라 모델 응답 안전성과 문화적 적절성을 구분해 측정해야 한다고 제안했다. 물리적 위해를 일으키지 않는 답변이라도 특정 문화에서는 예절이나 금기를 위반할 수 있어 '안전하다' 또는 '안전하지 않다'는 이분법적 평가만으로는 부족하다는 것이다.
아로요 박사는 "향후 더 많은 언어와 문화를 평가할 수 있는 기반을 만들어야 한다"며 "각 지역 현실을 존중하고 현지 전문가들과 협력하면서 문화적 특성을 이해하는 AI가 더 나와야 할 것"이라고 말했다.