노타의 멀티모달 인공지능(AI) 모델 최적화 기술이 세계적인 AI 학술대회에 채택되며 기술력을 인정받았다.
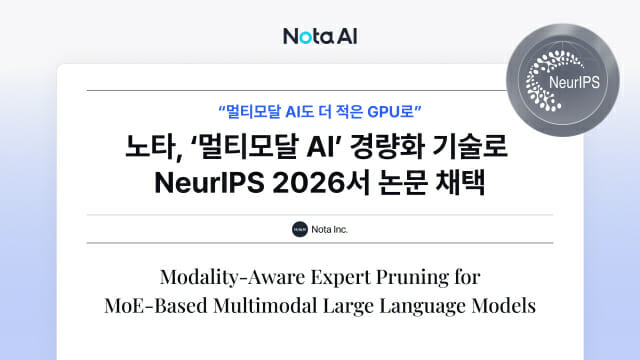
노타는 멀티모달 AI 모델의 성능 저하를 최소화하면서 그래픽처리장치(GPU) 메모리 사용량을 낮추는 연구 논문이 세계적인 AI 학술대회 '뉴립스(NeurIPS) 2026' 메인트랙에 채택됐다고 1일 밝혔다.
채택 논문은 '멀티모달 대규모 언어모델을 위한 모달리티 인지 전문가 프루닝(Modality-Aware Expert Pruning for MoE-Based Multimodal Large Language Models)'이다.
이번 연구는 텍스트와 이미지 등 다양한 정보를 함께 처리하는 멀티모달 AI에 맞춰 '전문가 프루닝' 기술을 고도화한 것이다. 전문가혼합(MoE) 모델에서 일부 전문가 모듈을 제거할 때 언어와 이미지 이해 능력을 함께 고려해 모델 성능과 구동 효율을 균형 있게 확보하는 것이 핵심이다.
성능 평가에서는 약 310억 파라미터 규모의 멀티모달 모델에서 전문가 모듈을 25% 제거했을 때 원본 성능의 98%를 유지했다. 전문가 모듈을 50% 제거한 경우에도 91%의 성능을 유지했으며 GPU 메모리 사용량은 58기가바이트(GB)에서 31GB로 약 47% 줄었다. 40GB 메모리를 갖춘 GPU 한 장으로도 모델을 구동할 수 있는 수준을 확보했다고 노타는 설명했다.
이는 최신 AI 모델을 도입할 때 고사양 GPU를 추가하는 대신 소프트웨어 최적화를 통해 기존 AI 인프라의 활용도를 높일 수 있다는 의미다. 모델 구동에 필요한 메모리를 줄이면 같은 GPU 자원에서 활용할 수 있는 모델의 범위를 넓히거나 여유 자원을 다른 모델과 서비스에 배분할 수 있다.
노타는 이번 기술을 자사의 AI 최적화 플랫폼 '넷츠프레소'에 반영해 멀티모달과 MoE 모델 지원 역량을 강화할 계획이다. 텍스트 중심에서 이미지와 영상, 음성 등을 함께 처리하는 멀티모달 AI 모델로 시장이 확대되는 만큼 넷츠프레소의 지원 모델과 고객 적용 범위도 넓힌다는 구상이다.
관련기사
- 노타, 퀄컴 NPU서 로봇 AI 가속…작업 속도 향상2026.09.22
- GPU 고르지 마세요…노타, 인텔 B70 기반 영상관제 패키지 출시2026.09.17
- 노타, LG전자·모빌린트와 NPU 기반 휴머노이드 두뇌 최적화2026.09.08
- 노타, '모두의 AI' SKT 컨소시엄 합류…실행형 AI 구현 지원2026.09.01
노타는 '키미 K3'와 '솔라 오픈 2' 등 초거대 모델에 전문가 프루닝을 적용하며 최적화 경험을 축적해 왔다. 올해 ICLR와 EMNLP, ICML에 이어 NeurIPS에서도 연구 성과를 인정받았다.
채명수 노타 대표는 "초거대 언어모델에서 축적해 온 최적화 역량을 멀티모달 AI까지 확대하는 중으로 최신 연구 성과를 넷츠프레소에 지속적으로 반영하고 있다"며 "AI 모델이 커지고 복잡해질수록 기업이 보유한 GPU와 AI 인프라를 보다 효율적으로 활용할 수 있도록 지원하는 최적화 기술의 가치도 커질 것"이라고 말했다.