인공지능(AI)의 확산으로 데이터센터 성능 병목이 메모리와 스토리지 계층으로 전이되는 가운데, SK하이닉스가 무거운 범용 중앙처리장치(CPU)의 전력·면적적 한계를 극복하기 위해 기능별로 프로세서를 쪼개고 효율을 극대화한 'H-TPU(Hynix-Transaction Processing Unit)' 아키텍처를 전격 공개했다.
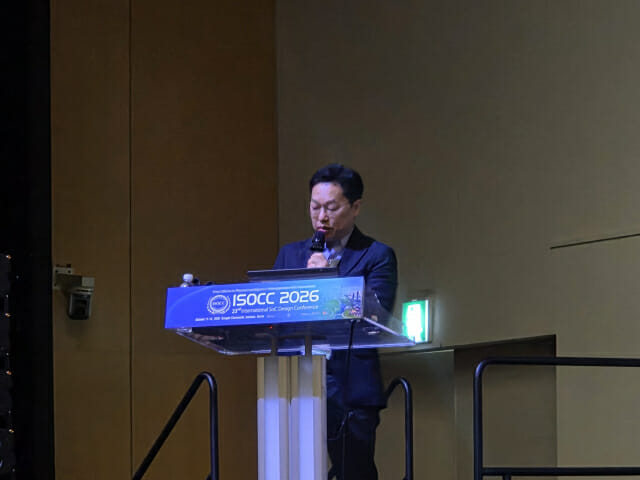
구인재 SK하이닉스 SoC 디자인 담당 부사장은 12일 인천 송도 컨벤시아에서 열린 '국제SoC학술대회(ISOCC) 2026' 기조연설에서 'SSD 컨트롤러에서 AI 메모리 SoC로: 지능형 메모리 시스템을 위한 SoC 아키텍처의 진화'라는 주제로 발표했다.
구 부사장은 이날 발표에서 AI 데이터센터가 직면한 구조적 한계부터 짚었다.
그는 "GPU 성능과 PCIe 대역폭이 매세대 2배씩 폭증하는 동안, SSD 컨트롤러 내부의 범용 CPU 주파수와 제어 능력은 이를 따라가지 못하는 한계에 다다랐다"고 지적했다.
전통적인 모놀리식 CPU 구조로는 스토리지 제어에 필요한 100여 가지 세부 펑션을 감당하기 어렵다. 과거에는 성능을 높이기 위해 CPU 코어 개수를 무작정 늘려왔으나, 이 경우 극심한 전력 낭비와 예측 불가능한 파이프라인 지연을 초래한다는 설명이다.
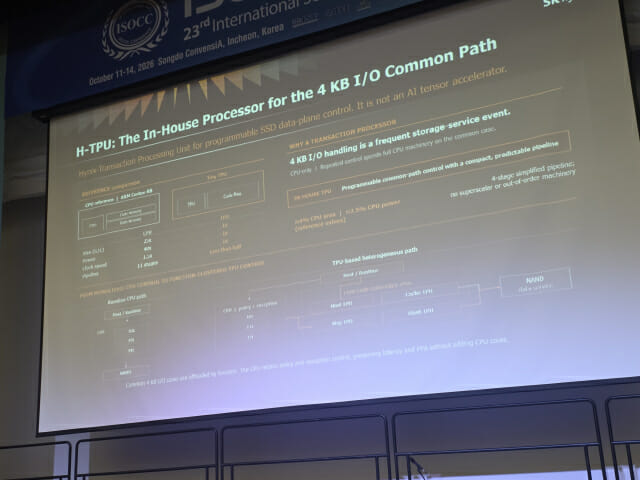
SK하이닉스는 이러한 CPU의 한계를 넘어서기 위해 자체 개발한 초경량 트랜잭션 전용 프로세서인 'H-TPU'를 솔루션으로 제시했다.
H-TPU는 AI 연산을 수행하는 텐서 가속기가 아니라, SSD 데이터 플레인 제어와 트랜잭션을 전담하는 프로그래머블 프로세서다. 거대한 범용 CPU 하나에 의존하던 방식에서 벗어나, 제어 기능을 세분화하고 프로세서를 기능 단위로 잘게 쪼개 수십 개의 소형 TPU 클러스터로 분산 배치한 것이 핵심이다.
구 부사장은 "H-TPU는 슈퍼스칼라나 비순차적 실행 장치를 배제한 간결한 4-스테이지 파이프라인을 적용했다"며 "범용 CPU 코어 대비 면적은 약 25분의 1(전체 CPU 면적의 약 4%), 전력 소모는 25분의 1(약 2.5%) 수준에 불과하다"고 설명했다.
이어 "쓰기 등 특정 작업에 연관된 기능 모듈만 동작하고, 미사용 모듈은 최소 전력 모드로 전환돼 컨트롤러 전체 전력을 극적으로 아낄 수 있다"고 덧붙였다.
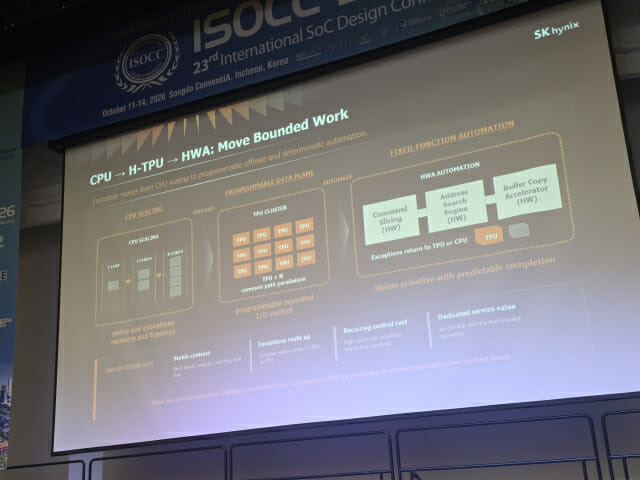
이 같은 H-TPU 구조는 향후 하드웨어 자동화(HWA, Hardware Automation) 단계로 이어진다.
HWA에서는 스토리지 제어 과정에서 매번 반복되는 명령어 처리, 데이터 주소 검색, 임시 저장소 복사 등 단순하고 소모적인 작업들은 아예 전용 하드웨어 회로에 통째로 맡겨 알아서 처리하게 만든다. 그리고 예외적인 오류 상황이나 핵심 정책 결정 같은 고차원적 업무만 CPU와 H-TPU가 넘겨받아 처리함으로써 시스템 효율을 극대화하는 방식이다.
이를 통해 시스템 전체에 결정론적이고 예측 가능한 완료 시간을 보장한다는 방침이다.
나아가 SK하이닉스는 H-TPU 중심의 컨트롤러 혁신이 차세대 메모리로 부상한 고대역폭 플래시 'HBF(고대역폭 플래시)'와 결합해 강력한 시너지를 낼 것으로 기대하고 있다.
AI 추론 환경은 읽기 대 쓰기 비율이 약 30만 대 1에 달할 정도로 극단적인 읽기 중심(WORM) 특성을 보인다. HBF는 이러한 추론 환경에서 낸드의 물리적 대용량과 고대역폭 서비스 아키텍처를 결합한 새로운 메모리 반도체다.
관련기사
- 마이크론, D램 2위 SK하이닉스 턱밑 추격…점유율 격차 1%포인트2026.10.03
- SK하이닉스, 'NPE' 모노리식3D 특허 8건 재심사 청구...모노리식3D 공격 대응2026.09.30
- SK하이닉스 손자회사 솔리다임, 美 첫 낸드 공장 구축 추진2026.09.18
- SK하이닉스, FMS서 '계층형 메모리' 기반 AI 인프라 전략 공개2026.08.07
구 부사장은 "AI 컴파일러와 런타임이 사전에 파악한 연산 데이터 흐름을 HBF SoC에 전달하면, HBF SoC가 버퍼 관리와 캐시 프리페치(Prefetch)를 미리 구동하게 된다"며 "이를 통해 낸드가 가진 물리적 접근 지연 시간을 연산 시간 뒤로 완벽히 숨길 수 있다"고 밝혔다.
이어 "컨트롤러가 서비스 경로 전체에서 요청 문맥을 보존해 낸드 플래시 용량을 실제 'AI 메모리 자원'으로 전환시킬 것"이라고 강조했다.