래블업이 한국어 질의와 인공지능(AI) 에이전트 작업에서 거대언어모델(LLM)의 답변 생성 속도를 높이기 위한 추론 가속 모델을 선보였다. AI 인프라 소프트웨어를 만들며 쌓은 경험을 바탕으로 한국어 모델 개발까지 사업 범위를 넓히는 모습이다.
래블업은 한국어에 최적화한 드래프트 모델 'GLM-5.2-NVFP4-DFlash-ko'를 한글날인 지난 9일 허깅페이스에 오픈소스로 공개했다고 12일 밝혔다.
이번 모델은 중국 지푸AI(Z.ai)의 오픈 LLM 'GLM-5.2'를 엔비디아의 4비트 부동소수점 형식(NVFP4)으로 구동할 때 함께 사용하는 보조 모델이다. z-lab이 공개한 'DFlash' 방식을 적용했으며 한국어 질의와 에이전트 작업에 맞춰 학습했다.
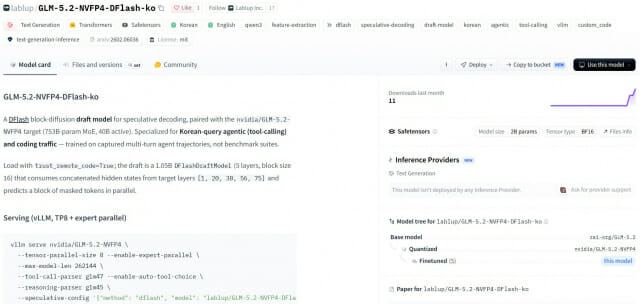
드래프트 모델은 투기적 디코딩 기술에 활용된다. 작은 모델이 다음에 생성할 여러 토큰을 예측하면 큰 모델이 이를 한 번에 검증하는 방식이다. 큰 모델이 최종 결과를 결정하기 때문에 답변 품질을 유지하면서 생성 속도를 높일 수 있다. DFlash는 여러 토큰을 순차적으로 예측하는 대신 한 번에 생성하는 것이 특징이다.
래블업에 따르면 영어 데이터로 학습한 기존 드래프트 모델은 한국어 환경에서 토큰 예측 적중률이 낮아 가속 효과가 줄어드는 한계가 있었다. 이에 한국어 데이터로 드래프트 모델을 학습해 한국어 질의와 에이전트 작업에서도 가속 성능을 유지하도록 했다.
실제 한국어 에이전트 트래픽을 활용한 평가에서 이번 모델의 평균 수락 길이(MAL)는 에이전트 작업 2.71, 한국어 질의 2.77을 기록했다. 평균 수락 길이는 한 번의 검증에서 받아들여지는 토큰 수를 의미한다. 회사 측은 영어 기반 DFlash 모델과 유사한 수준의 가속 성능을 확보했다고 설명했다.
래블업은 후속 모델 개발도 진행하고 있다. Z.ai의 'GLM-5.3-Flash'를 위한 한국어 드래프트 모델을 개발 중이며 별도로 약 110억 파라미터 규모의 한국어 디퓨전 언어모델을 처음부터 학습하고 있다.
한국어 디퓨전 언어모델은 로컬 기기에서 AI 에이전트 작업을 수행할 수 있는 온디바이스 모델을 목표로 한다. 학습에는 엔비디아 B200 그래픽처리장치(GPU) 64장 규모의 클러스터를 활용하고 있으며 GPU 자원 일부는 과학기술정보통신부와 정보통신산업진흥원(NIPA)의 '첨단 GPU 활용 지원 사업'을 통해 지원받았다.
관련기사
- 래블업, GPU 넘어 AI 토큰 사용료까지 통합 관리2026.10.07
- 신정규 래블업 대표 "AI도 전기처럼 쓰는 시대…복잡한 인프라 쉽게 바꿀 것"2026.09.29
- 래블업이 제시한 AI 모델·인프라 통합 운영 전략은2026.09.09
- 래블업, 코스닥 상장 공식 출사표2026.08.25
래블업은 코스닥 상장도 추진하고 있다. 증권신고서를 제출하고 공모 절차에 착수했으며 오는 13일부터 19일까지 기관투자자 대상 수요예측을 진행할 예정이다.
신정규 래블업 대표는 "드래프트 모델이 영어로 학습돼 있으면 한국어 사용자는 투기적 디코딩의 가속 효과를 온전히 얻기 어려웠다"며 "AI 서비스를 만드는 개발자와 기업이 한국어 환경에서도 가속 효과를 얻을 수 있도록 한글날에 맞춰 한국어 드래프트 모델을 공개했다"고 말했다.