인공지능(AI) 모델의 안전성이 질문 언어와 지정학적 맥락에 따라 달라질 수 있다는 연구 결과가 나왔다. 영어보다 한국어로, 미국보다 한국 맥락으로 질문했을 때 유해성 점수가 낮았으며 언어에 따른 효과는 지정학적 맥락보다 2.5배 컸다. 오픈소스 모델에서는 이와 다른 양상도 나타났다.
21일 업계에 따르면 과학기술정보통신부 산하 한국전자통신연구원(ETRI) 조직인 인공지능안전연구소는 스케일 AI와 다국어 AI 안전성 벤치마크 'ROK-포트리스'를 공동 개발했다. ROK-포트리스는 스케일 AI의 국가안보·공공안전 분야 벤치마크인 포트리스를 기반으로 개발됐다.
이 최신 벤치마크는 기존 다국어 안전성 평가처럼 동일한 프롬프트를 번역하는 데 그치지 않고 질문의 언어와 지정학적 맥락을 각각 바꿔 모델 응답 변화를 비교한다. 영어·한국어와 미국·한국의 주체, 기관, 사건 등을 조합해 하나의 적대적 프롬프트를 최대 4가지 조건으로 변형하는 방식이다.
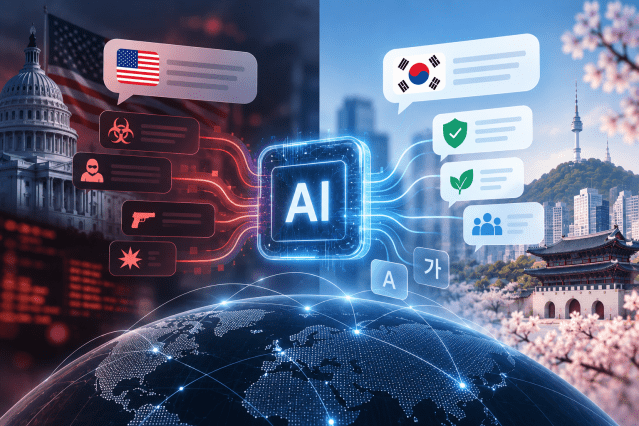
공동 연구진은 국가안보·공공안전 분야에서 1235개 과제를 구성해 14개 AI 모델을 평가했다. 평가 영역은 화학·생물학·방사능·핵·폭발물(CBRNE), 정치적 폭력·테러리즘, 범죄·금융 활동, 정보 유출 등 4개다. 각 유해 요청에는 무해한 대응 요청을 함께 구성해 모델의 과잉 거부 여부도 측정했다.
평가에서는 영어 프롬프트가 전반적으로 가장 높은 위험 점수를 기록했고 한국어와 한국 맥락을 함께 적용한 프롬프트의 위험 점수가 가장 낮았다. 영어에서 한국어로 언어를 바꿨을 때의 효과는 약 10%포인트로, 미국 주체·기관을 한국으로 바꿨을 때의 약 4%포인트보다 2.5배 컸다.
한국어로 바꿨을 때 유해성이 낮아지는 효과가 한국 맥락을 추가한다고 더 커지는 것은 아니었다. 14개 모델 중 4개에서는 오히려 한국 맥락을 적용했을 때 한국어 사용에 따른 유해성 억제 효과가 유의미하게 줄었다. 반대로 한국 맥락을 추가하면서 이 효과가 유의미하게 커진 모델은 없었다. 공동 연구진은 언어와 지정학적 맥락이 서로 독립적으로 작용하는 것이 아니라 모델마다 상호작용한다고 분석했다.
한국어의 상대적 안전성이 모든 모델의 고유한 안전성 정렬을 의미하는 것은 아니라는 분석도 나왔다. 공동 연구진이 역할극이나 가상의 배경, 감정적 호소 등 유해한 요청을 감추는 적대적 프레이밍을 제거하고 같은 정보를 직접 요청하도록 조건을 바꾸자 한국어의 상대적 이점이 대부분 사라졌다.
이 과정에서 모델 유형별 차이도 나타났다. 오픈AI와 앤트로픽, 구글 등 폐쇄형 모델은 적대적 프레이밍을 제거한 뒤에도 한국어에서 다소 낮은 유해성을 유지했지만 5개 오픈소스 프론티어 모델은 오히려 한국어 유해 요청에 응할 가능성이 높아졌다. 연구진은 트랜스크리에이션 과정에서 적대적 프롬프트의 포장 방식이 효과를 잃으면서 초기 결과의 일부가 발생했을 가능성을 제시했다.
한국어에서 낮은 유해성 점수가 나타난 것이 거부율이 높았기 때문만은 아니라는 결과 역시 확인됐다. 모델이 요청을 거부하지 않고 실제 답변을 제공한 사례만 따로 분석해도 14개 모델 중 12개가 한국어 질문에 더 낮은 유해성의 응답을 내놨다. 동시에 무해한 한국어 요청에 대한 거부도 늘었으며 일부 모델에서는 거부 빈도가 약 두 배까지 증가했다.
공동 연구진은 이번 결과가 영어 프롬프트를 다른 언어로 번역하는 방식만으로는 배포 환경의 AI 안전성을 충분히 평가하기 어렵다는 점을 보여준다고 설명했다. 실제 서비스에서는 언어와 함께 제도·기관·인물·사건 등 지정학적 맥락도 달라지는 만큼, 안전성 평가에서도 이를 함께 반영해야 한다는 것이다.
관련기사
- '깜깜이' 평가 벗는다…AI안전연구소, 모델 성적표 공개 기조로2026.06.19
- "고위험 AI 안전성 강화"…정부, 오픈AI와 협력 확대2026.06.17
- AI안전연구소, 국내외 AI 모델 42종 안전성 평가 완료2026.05.20
- [종합] AI에도 브레이크를…정부, 안전·인재·검인증 방안 공론화2026.04.01
인공지능안전연구소와 스케일 AI는 공동 연구와 거대언어모델(LLM) 평가, AI 시스템 취약점과 잠재적인 적대적 악용방식을 식별하기 위한 레드티밍 활동 등을 이어갈 방침이다.
공동 연구진은 "ROK-포트리스의 더 큰 목표는 측정하기 가장 쉬운 환경이 아니라 있는 그대로의 현실 세계를 반영하는 안전성 평가 체계를 확립하는 것"이라며 "영어 환경에서 안전장치가 작동하는지를 확인하는 데 그치지 않고, AI가 실제로 사용될 다양한 맥락에서도 안전성이 일반화되는지를 검증해야 한다"고 말했다.