온디바이스·엣지AI의 핵심 연산을 담당해온 모바일용 시스템반도체(SoC)의 AI 가속 구조가 신경망처리장치(NPU) 중심에서 GPU를 함께 활용하는 방향으로 바뀌고 있다.
생성 AI와 거대언어모델(LLM), 에이전틱 AI 등 처리해야 할 AI 작업이 한층 다양해지며 병렬 연산에 강점을 가진 GPU의 역할이 커진 것이다.
퀄컴과 Arm은 최근 GPU에 AI 연산 전용 신경망 가속기를 통합했고, 애플도 M5에 이어 차세대 아이폰용 A20 프로 GPU에 신경망 가속기를 적용했다.

퀄컴과 Arm, 애플이 잇따라 GPU에 AI 전용 가속기를 통합하는 것은 이처럼 AI 연산의 일부를 GPU로 분산해 복잡한 AI 작업에 대응하려는 전략으로 해석할 수 있다.
퀄컴, 차세대 아드레노 GPU에 AI 연산 접목
퀄컴은 모바일용 스냅드래곤8 엘리트, PC용 스냅드래곤X2 엘리트 등 SoC 제품에서 그동안 NPU의 AI 처리 성능과 전력 효율을 강조해왔다. 여러 AI 모델이 동시에 작동하는 환경에서는 전력 효율이 높은 NPU가 모바일·PC AI의 핵심 경쟁력이라는 취지였다.
그러나 퀄컴은 이달 2일 아드레노 GPU에 AI 처리 전용 코어인 '아드레노 매트릭스 코어(AMC)'를 추가한다고 밝혔다. 고성능 AI 연산에 필요한 기능을 NPU나 CPU에 넘기지 않고 GPU 내부에서 직접 처리한다는 것이다.
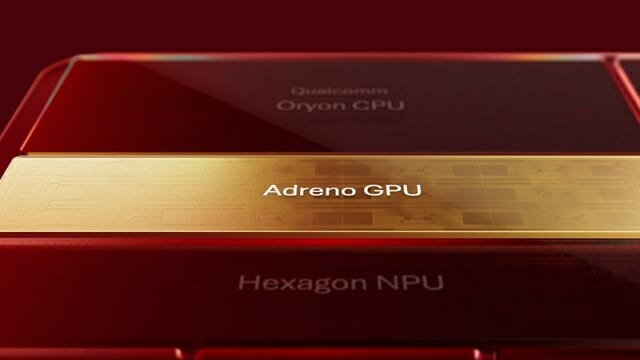
퀄컴은 AI 처리를 GPU에서 직접 수행하는 것이 아드레노 GPU 역사상 처음이라고 설명했다. 이를 통해 개발자들이 복잡한 렌더링 모델을 보다 낮은 지연시간과 전력으로 수행할 수 있다는 설명이다.
Arm도 말리 G2-울트라 NX GPU에 AI 연산 추가
모바일용 SoC의 설계자산(IP)을 공급하는 영국 Arm도 이달 8일 프리미엄 스마트폰과 태블릿, PC 등 모바일 기기를 겨냥한 새로운 반도체 IP '모바일용 CSS 2'를 공개했다.
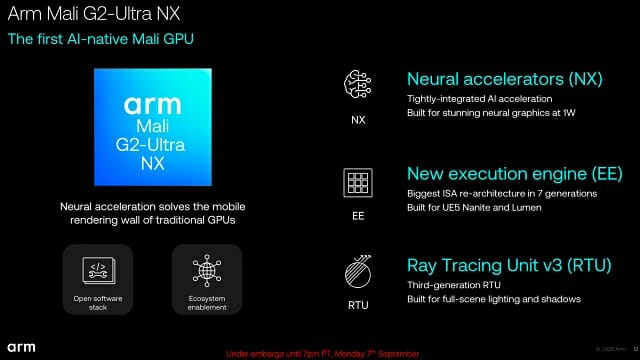
모바일용 CSS 2는 각종 연산작업을 수행하는 C2 CPU와 그래픽 및 AI 가속을 담당하는 말리 G2-울트라 NX GPU로 구성된다. 이중 말리 G2-울트라 NX GPU에는 신경망 가속기가 통합됐다.
Arm은 GPU에 통합된 신경망 처리 기능을 이용해 저해상도 화면을 고해상도로 보정하는 신경망 슈퍼샘플링(NSS), 초당 30프레임 화면을 60프레임 수준으로 높이는 신경망 프레임 업스케일링 등을 구현할 수 있다고 밝혔다.
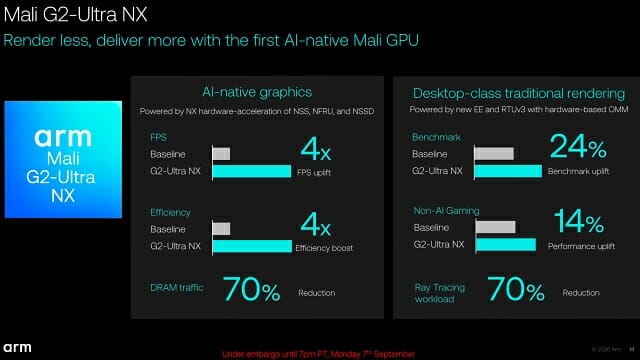
이는 GPU가 그래픽과 AI 연산을 보다 긴밀하게 처리하도록 하는 구조다. Arm은 말리 G2-울트라 NX GPU의 실제 AI 처리 성능을 약 10~20 TOPS 내외로 예상했다.
애플, M5 이어 A20 프로 GPU에도 신경망 가속기 추가
애플은 2017년 아이폰8·X에 탑재한 SoC 'A11 바이오닉'에 NPU인 뉴럴 엔진을 처음 통합하고 사진·음성·자연어 처리 등 특정 AI 연산에 활용했다.
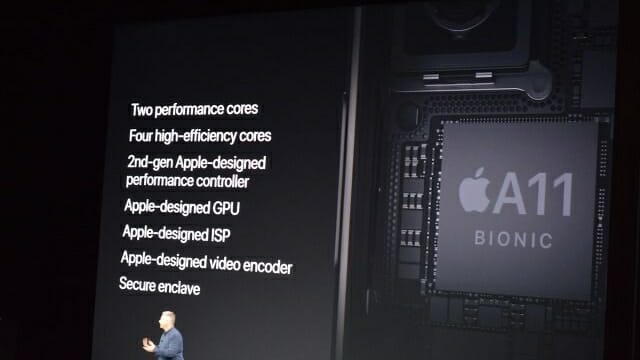
애플 역시 최근에는 GPU의 AI 처리 능력을 강화하고 있다. 지난해 10월 공개한 아이패드 프로·맥용 SoC M5의 GPU에 신경망 가속기를 통합한 데 이어 차세대 아이폰용 A20 프로도 GPU에 신경망 가속기를 적용했다.
A20 프로의 GPU는 전 세대보다 1개 많은 7개 코어로 구성되며, GPU 내부에 신경망 가속기를 내장해 FP8(8비트 부동소수점) 연산 성능을 최대 두 배 높였다. A20 프로는 GPU와 별개로 NPU 역할을 하는 32코어 뉴럴 엔진도 함께 탑재한다.
저전력으로 지속적으로 실행해야 하는 AI 작업은 여전히 뉴럴 엔진이 담당하지만 높은 연산 성능이 필요한 AI 작업에서 GPU의 역할을 강화한 것이다.
GPU 병렬 연산, 복잡한 AI 처리에 적합
NPU는 주위 소리 확인, 음성 인식 등 저전력으로 지속 처리가 필요한 작업에 적합하다. 그러나 AI 모델의 크기가 커지고 연산 과정이 복잡해지면서 NPU만으로 모든 AI 작업을 빠르게 처리할 수 없게 됐다.
특히 모바일 기기에서 구동되는 스테이블 디퓨전·플럭스 계열 이미지 생성, 거대언어모델(LLM), AI 영상 생성·변환, 실시간 AI 이미지 편집 등은 대규모 병렬 연산과 높은 메모리 대역폭을 요구하는 대표적인 사례다.
이런 작업에서는 GPU가 가진 높은 병렬 연산 능력과 메모리 대역폭, 다양한 연산을 유연하게 수행할 수 있는 구조가 장점으로 작용한다.
2나노급 공정으로 GPU 확대 여유 증가
모바일 SoC는 PC/서버용 프로세서와 달리 스마트폰 내부의 제한된 면적을 활용해 CPU·GPU·NPU 등 주요 연산 블록을 집적하는 구조다. 때문에 특정 연산 장치를 대폭 강화하기 어려웠다.
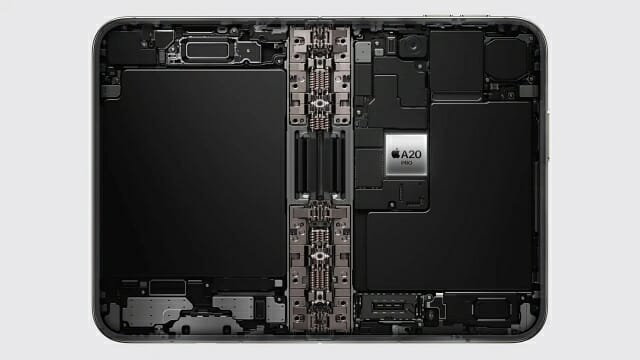
이달 공개된 차세대 모바일 SoC는 모두 TSMC N2와 삼성전자 SF2 등 2나노급 공정을 염두에 둔 제품들이다. 2나노급 공정 도입에 따른 트랜지스터 집적도 향상은 이들 연산 블록을 확대할 수 있는 설계 여유를 제공한다.

TSMC에 따르면 N2는 N3E(3나노급) 대비 동일 면적에서 15% 이상 높은 트랜지스터 밀도를 제공한다. 이를 단순히 면적에 환산하면 동일한 회로를 구현할 때 이론적으로 약 13%의 면적을 줄일 수 있는 수준이다.
GPU+AI 결합 모바일 SoC, 이 달부터 시장 진입
새로운 GPU를 통합한 모바일용 SoC는 올해 애플 아이폰18 프로와 아이폰 듀오를 시작으로 내년 퀄컴과 미디어텍 등 주요 제조사를 통해 스마트폰과 태블릿에 투입될 예정이다.
이에 따라 모바일 AI의 성능을 평가하는 기준도 변화할 가능성이 커졌다.
관련기사
- 애플, 아이폰용 첫 2나노급 SoC 'A20 프로' 공개2026.09.10
- Arm, 모바일용 CSS 2 공개... 말리 GPU에 신경망 가속기 통합2026.09.08
- 퀄컴 "새 오라이언 CPU, 모바일 최초 작동클록 5GHz 돌파"2026.08.26
- Arm, 서버 CPU용 IP '네오버스 CSS N4' 공개2026.09.08
지금까지는 주로 NPU의 TOPS가 온디바이스 AI 성능을 나타내는 주요 지표로 활용됐지만, 앞으로는 GPU 내 신경망 처리 기능을 활용한 그래픽 성능과 AI 연산 성능도 중요한 평가 기준으로 부상할 전망이다.
다만 GPU에 AI 가속기를 통합했다고 해서 실제 성능이 자동으로 향상되는 것은 아니다. 운영체제와 AI 프레임워크, 개발 도구가 새로운 가속기를 지원하고 개발자가 이를 활용하도록 모델과 소프트웨어를 최적화해야 한다.