자바5부터 등장한 어노테이션은 오픈소스에도 점차 그 영향력을 넓혀가고 있다. 버전호환성이 중요한 상용기술에 비해서 새로운 기술을 빨리 응용할 수 있는 것이 오픈소스의 장점이기 때문에 어노테이션을 이용한 기술 활용의 정도는 오픈소스에서 점점 더 빨라질 것으로 보인다. 대표적인 오픈소스 제품의 어노테이션 적용 예를 통해서 앞으로의 어노테이션 기술 발전가능성에 대해 살펴보자.
자바의 어노테이션 기술은 자바5라는 언어차원의 큰 변화가 일어나는 시점에 등장했다. 그 이전까지 소스코드 레벨의 메타정보 기술에 대한 많은 요구들이 있었지만 언어의 변화는 최소화한다는 정책을 고수하던 자바의 뜻에 따라 좀처럼 어노테이션류의 기술도입은 자꾸 지연되었다.
그 사이 자바의 표준기술에서는 모든 메타정보는 XML 형태로 관리되는 전략을 취해왔다. XML이 메타정보를 관리하는 측면에서의 많은 장점이 있는 것은 사실이지만 소스코드와 면밀히 연동해서 관리될 수 있는, 특별히 소스레벨의 메타정보를 참조할 수 있는 코드 내의 어노테이션 기술이 그만큼 아쉬웠던 것이 사실이다.
특히 닷넷이 어트리뷰트를 적용하는 등의 움직임을 보면서 많은 자바 개발자들이 부러워하기도 했다.
XDoclet이 메타정보를 주로 XML 형태로 변환하고 런타임 시에 XML을 읽어서 처리하는 두 단계를 거치는 구조로 되어있다면 커먼 어트리뷰트는 XML 과정 없이 바로 메타정보가 담긴 클래스 형태로 변환이 되어 메타정보를 그대로 사용할 수 있다.
스프링프레임워크는 JDK1.5 이전 버전의 사용자를 위해서 커먼 어트리뷰트를 적극적으로 도입한 대표적인 프로젝트다. 기본적인 빈(Bean) 설정에서부터 트랜잭션 처리 MVC의 매핑, JMX Bean 설정 까지 다양한 형태로 커먼 어트리뷰트를 지원한다.
<리스트 3>은 서비스 빈의 트랜잭션 메타정보를 커먼 어트리뷰트를 이용해서 적용한 예이다. @@으로 시작하는 커먼 어트리뷰트 정보는 런타임 시에 스프링AOP에 의해서 참조되어 적용된다.
<리스트 3>스프링프레임워크의 커먼 어트리뷰트 적용 예
오픈소스는 자바의 가려운 데를 긁어주는 역할을 하고 있었으니 역시 이런 상황을 그냥 보고만 지나칠 수 없었다. 그래서 몇 가지 메타정보를 소스 내에 삽입하는 기술이 등장했다. 이런 기술들은 개발자의 소스코드 메타정보에 대한 욕구를 어느 정도 채워줄 수 있었다.
XDoclet
첫 번째로 가장 성공한 소스레벨의 메타정보 삽입 기술은 XDoclet이다. XDoclet은 사실 EJB의 과도한 XML 메타정보 작성에 지친 개발자들이 일종의 메타코드 생성기술을 응용하여 적용하기 시작한 것이다.
자바의 API 문서 생성을 위한 XDoc 기술을 이용해서 코드 내의 코멘트 영역에 정보를 삽입하면 이를 별도의 컴파일러로 추출해서 원하는 작업을 수행하는 것이 기본적인 아이디어다.
XDoclet의 EJB 메타 정보를 소스코드에 삽입하는 기술은 EJB를 제대로 쓰기 위해서는 고가의 상용 툴을 사용해야만 했던 개발자들에게는 매우 반가운 소식이었다. 결과적으로 EJB XDoclet의 인기는 매우 높아졌고 그 아이디어에 만족한 많은 개발자들에 의해서 EJB외에도 여러 가지 종류의 기술을 위한 XDoclet 엔진을 개발하기 시작했다.
대표적인 XDoclet 엔진에는 다음과 같은 것들이 있다.
• @ejb: EJB 메타 정보
• @struts : 아파치 Struts 설정 정보
• @jboss: JBoss설정 정보
• @weblogic: BEA Weblogic 설정 정보
• @hibernate : 하이버네이트 2.x의 매핑정보
• @spring: Spring Bean 설정 정보
<리스트 1>은 하이버네이트 XDoclet을 이용해서 간단한 오브젝트-테이블 매핑을 엔티티 소스코드 내에 삽입한 예이다.
클래스나 메소드의 코멘트 영역에 @마크를 단 XDodclet 태그를 적용하면 이를 ANT의 태스크를 이용해서 <리스트 2>와 같은 하이버네이트 매핑파일을 자동으로 생성할 수 있다.
ANT를 이용하여 빌드과정에서 항상 이 작업이 수행되도록 하면 소스코드 내의 설정을 통해서 연속적인 설정파일의 변경할 수 있다.
XDcolet은 그 자체로 매우 성공한 프로젝트이며 소스 내의 메타정보 활용에 대한 매력을 개발자들에게 보여줬다는 면에서 의미가 크다. 하지만, 코드나 설정파일 생성 기술에 주로 이용된다는 점과 별도의 과정을 통한 빌드타임에서 동작한다는 면에서 진정한 메타정보로 활용되는 것이라고 보기는 어렵다.
아파치 커먼 어트리뷰트
커먼 어트리뷰트(Commons Attribute)는 XDoclet과 비슷한 구조로 XDoc을 이용해서 소스코드 내의 메타정보를 사용할 수 있도록 해주는 기술이다.
XDoclet이 주로 EJB처럼 복잡한 설정정보를 소스코드와 연동해서 설정 파일로 만들어내는 빌드타임에 주로 적용되는 기술인데 반해서 커먼 어트리뷰트는 코드 내의 메타정보를 런타임 시에 효과적으로 사용할 수 있도록 하는데 초점이 맞춰져 있다.
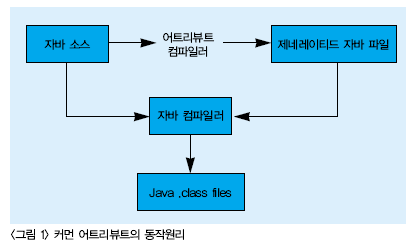
<그림 1>은 커먼 어트리뷰트의 동작원리를 보여준다. 자바 소스코드 내에 삽입된 메타정보(어트리뷰트)를 어트리뷰트 컴파일러(Attribute Compiler)를 통해서 그 정보를 담고 있는 자바소스로 생성해낸다. 이소스는 일반 클래스로 컴파일 되고 런타임 시에 커먼 어트리뷰트의 API를 통해서 그 정보를 가져와 사용할 수 있도록 되어있다.
XDoclet이 메타정보를 주로 XML 형태로 변환하고 런타임 시에 XML을 읽어서 처리하는 두 단계를 거치는 구조로 되어있다면 커먼 어트리뷰트는 XML 과정 없이 바로 메타정보가 담긴 클래스 형태로 변환이 되어 메타정보를 그대로 사용할 수 있다.
스프링프레임워크는 JDK1.5 이전 버전의 사용자를 위해서 커먼 어트리뷰트를 적극적으로 도입한 대표적인 프로젝트다. 기본적인 빈(Bean) 설정에서부터 트랜잭션 처리 MVC의 매핑, JMX Bean 설정 까지 다양한 형태로 커먼 어트리뷰트를 지원한다.
<리스트 3>은 서비스 빈의 트랜잭션 메타정보를 커먼 어트리뷰트를 이용해서 적용한 예이다. @@으로 시작하는 커먼 어트리뷰트 정보는 런타임 시에 스프링AOP에 의해서 참조되어 적용된다.
스프링 프레임워크에서 사용되는 대표적인 커먼 어트리뷰트의 주된 용도는 스프링MVC의 핸들러 매핑이다. 최근 등장하는 웹 프레임워크들이 적극적으로 수용하고 있는 컨트롤러 내의 매핑스타일을 이미 스프링은 초기부터 적용해온 셈이다.
<리스트 4>는 스프링MVC의 PathMap을 이용한 컨트롤러 매핑의 예이다. 이렇게 정의된 컨트롤러는
CommonsPathMapHandlerMapping에 의해서 /bar.do라는 URL과 매핑을 XML에 일일이 설정하지 않아도 된다.
이렇게 커먼 어트리뷰트를 이용한 메타정보 활용방법은 닷넷에서 사용하는 어노테이션 기술 못지않게 편리하게 적용할 수 있다.
하지만 지금까지 살펴본 XDoclet이나 커먼 어트리뷰트는 몇 가지 단점을 가지고 있다.
첫 째는 빌드타임의 복잡한 작업이 필요하다는 것이다. 두 가지 모두 ANT와 Maven 등을 지원하기는 하지만 매번 빌드스크립트를 실행시켜야 하는 것은 자동 빌드에 익숙한 IDE를 사용하는 개발자들에게는 번거로운 일이 아닐 수 없다. 게다가 변환과 컴파일 시간에 대한 부담도 가져야 한다.
두 번째는 메타정보에 접근하는 표준 기술이 아니라는 점이다. 따라서 써드파티(3rd-party) 프레임워크나 라이브러리에서 이런 기능을 제공한다고 할지라도 사용하는 프로젝트의 기술셋에는 적용할 수 없는 경우가 종종 발생한다.
자바5에 등장한 어노테이션(Annotation)기술은 지금까지 XDoc 등을 이용한 변칙적인 방법의 사용이 더 이상 필요 없도록 자바 언어 차원에서 메타정보를 기술할 수 있는 것이다. 자바 어노테이션의 등장에 많은 개발자들이 찬사를 보냈고 다양한 새로운 제품에 빠르게 도입되어져 갔다.
오픈소스도 예외일 수 없다. 오픈소스는 제품의 새로운 버전이나 기능을 추가하는 면에서 일반 상용제품에 비해서 어느 정도 유리한 측면이 있다.
따라서 기존에 존재하는 오픈소스제품 뿐만 아니라 새로 등장하는 많은 오픈소스 프로젝트들이 자바5 이상의 제약을 감수하더라도 어노테이션을 적극 사용하기에 이르렀다. 많은 프로젝트가 어노테이션을 쓰기 위해서 자바5 이상이라는 조건을 걸었다고 했을 정도니 그 인기를 실감할 수 있을 것이다.
자바5의 어노테이션 기술은 컴파일 시와 런타임 시 모두 활용되어질 수 있으며 그 정의가 간단하고 참조하는 것도 자바의 리플렉션 API를 이용하면 간단히 처리할 수 있다.
더 고무적인 것은 자바5를 이용하는 JEE1.5에서는 표준 스펙에 본격적인 어노테이션을 적용했다는 사실이다. 이제까지 복잡하고 작성하기 어려운 XML형태의 설정을 고집했던 EJB는 어노테이션을 통한 간결한 설정을 주요 장점으로 내세우면서 다시금 인기몰이를 하고 있다.
이러한 흐름 속에서 주요한 오픈소스 제품이 어떻게 언어차원에서 지원하는 어노테이션을 사용하고 있는지를 살펴보자.
하이버네이트 3.x
하이버네이트는 2.x버전까지는 XML을 이용한 설정만을 지원했다. 물론 하이버네이트의 설정 XML은 지능적인 디폴트와 간결한 설정 구성 등을 이용해서 EJB나 스트러츠류의 복잡한 XML과 비교해볼 때 훨씬 간결하게 설정할 수 있다.
그럼에도 퍼시스턴트 오브젝트와 긴밀하게 연결되어있는 매핑 정보이기 때문에 소스코드에 삽입되면 훨씬 유리한 측면이 있었던 것이 사실이다. 그 때문에 하이버네이트 2.x에서는 Xdoclet을 이용한 매핑정보 생성기술이 가장 대중화되고 인기 있는 사용방법이었다.
하이버네이트가 3.0으로 가는 과정에서 일어난 가장 큰 변화는 하이버네이트 개발팀이 주력으로 참여한 EJB3.0의 JPA 기술과 연동이다. 하이버네이트는 3.x에서 일종의 JPA 구현엔진으로 변신을 꾀했다.
사실 하이버네이트 3.0 기술의 서브셋이 JPA로 갔다고 해도 무방하다. 오픈소스 ORM 엔진으로 가장 큰 성공을 거둔 것이 하이버네이트였고 2.x까지 가장 많은 비판에 시달린 엔티티빈을 획기적으로 개선하는데 가장 큰 영향을 발휘한 것이 바로 EJB3.0의 초기 JPA 스펙 대부분을 작성한 하이버네이트의 창시자인 개빈 킹(Gavin King)이었기 때문이다.
한편에서는 EJB3.0이 바로 하이버네이트3.0이 아니냐는 비판이 나올 정도로 그 둘은 매우 흡사하다. 하이버네이트 팀은 POJO 기반의 트랜스패런트 퍼시스턴트 기술이라는 측면을 제외하면 서로 상관없는 제품이라고 부정하기는 했으나 그 둘을 사용해본 사람이라면 얼마나 유사한 툴인지 충분히 인식할 수 있을 것이다.
하이버네이트 3.x의 매핑 설정에는 드디어 어노테이션이 적용되었다. EJB와의 공존공생을 노린 전략에 맞게 그 설정은 기본적으로 JPA의 어노테이션을 그대로 사용했다. 따라서 하이버네이트 어노테이션 프로젝트는 EJB3 JPA의 어노테이션을 그대로 사용할 수 있다. 단지, 하이버네이트에 많은 추가적인 기능들을 위해서 하이버네이트 어노테이션이 보조적으로 사용할 수 있다.
하이버네이트 3.x에서 여전히 XML을 이용한 매핑 설정이나 Xdoclet의 적용이 가능하긴 하다. 하지만 자바5 이상을 사용하는 개발자들은 당연히 어노테이션을 적용할 것이다.
위에서 살펴본 Xdoclet을 이용한 하이버네이트 매핑 설정을 어노테이션을 이용한 것으로 다시 살펴보자. <리스트 5>는 하이버네이트가 지원하는 JPA 어노테이션과 하이버네이트 전용 어노테이션을 결합해 적용한 엔티티 클래스의 예이다.
여기서 사용한 어노테이션 중에서 @Entity와 @Id, @GeneratedValue는 JPA의 표준 어노테이션이고 @Cache는 하이버네이트의 전용 어노테이션이다. 이 둘을 적절히 혼용해서 하이버네이트에 최적화된 설정을 만들어 낼 수 있다. 캐시(Cache)처럼 보조적인 설정이라면 이 설정을 그대로 다른 JPA 엔진에 적용하는 것도 충분히 가능하다.
기존의 XDoclet류에 비해서 어노테이션 설정방식이 가지는 장점을 살펴보자.
첫 째는 별도의 빌드과정이 필요 없다는 점이다. 이는 표준 기술이 주는 대표적인 장점 중의 하나이다.
두 번째는 Enum 등을 사용할 수 있기 때문에 타입의 안정성이 보장된다는 점이다. 어노테이션의 설정을 사용하다보면 Enum이 자주 등장하는 것을 알 수 있을 것이다.
세 번째는 클래스의 기본적인 메타정보를 그대로 활용할 수 있다는 것이다. <리스트 6>은 ManyToOne 관계의 릴레이셔널 필드의 설정 예이다. Xdoclet의 ManyToOne 설정에는 타깃 클래스의 이름과 외래키로 사용될 필드명이 들어가야 한다. 하지만 어노테이션을 이용한 ManyToOne 설정에는 이것을 생략할 수 있다.
이것은 클래스의 메타정보를 이용해서 타깃 엔티티가 DUser라는 것을 알아낼 수 있기 때문이다. 외래키는 디폴트 네이밍 룰을 이용해서 자동으로 부여된다. 물론 XDoclet에서도 이를 알아낼 방법은 있지만 어노테이션을 이용한 경우가 훨씬 편리하기 때문에 JPA와 하이버네이트 어노테이션에서는 이런 식의 간결한 설정을 자주 만날 수 있다.
네 번째는 IDE의 지원이다. 표준 언어 기술인 어노테이션은 당연히 대부분의 자바IDE에서 지원한다. 당연히 자동빌드를 통해서 오류도 검증해준다. Xdoclet도 자동완성 기능들을 지원하는 IDE가 있었지만 그 편리함은 비교할 바가 아니다.
하이버네이트는 자바5 이전 사용자나 XML 설정을 선호하는 개발자들을 위해서 호환성 차원에서 코어패키지에는 XML 지원 기능만 있고 어노테이션은 옵션 모듈로 제공한다.
스프링 프레임워크 2.x
스프링 프레임워크도 2.0에서부터 본격적으로 어노테이션을 지원하기 시작했다.
● 메타데이터 어트리뷰트(Metadata Attributes)
스프링의 메타정보 설정방식은 이전의 커먼 어트리뷰트와 어노테이션 두 가지를 모두 지원하는데 스프링은 이를 다시 추상화해서 스프링 메타데이터(Spring Metadata)의 어트리뷰트(Attributes)라는 인터페이스를 통해서 일관된 방식으로 접근한다.
다양한 구현과 적용 방법이 존재할 경우 항상 추상화를 통한 느슨한 관계를 설정하는 것을 지향하는 스프링으로써는 당연한 결과일 것이다.
스프링 메타데이터 어트리뷰트(Spring Metadata Attribute)의 도입 목적은 단지 어노테이션과 이전 커먼 어트리뷰트 기술에 대한 호환성문제 때문만은 아니다. 스프링 메타데이터 어트리뷰트는 다음과 같은 이유로 인해서 개발되었다.
첫째는 자바언어의 어노테이션은 스태틱한 기술이라는 것이다. 한번 컴파일되서 클래스 안에 그 정보가 삽입되면 수정할 수 없고 조회만 가능하다. 물론 리플렉션을 이용해서 강제로 어노테이션 정보를 수정할 수는 있지만 이는 바람직한 접근방법이 아니다.
두 번째로 어노테이션 정보를 XML에서처럼 계층적으로 표현해야 할 경우가 있기 때문이다. 또 많은 경우에 이를 오버라이딩하는 것도 필요하다.
세 번째로는 자바5의 어노테이션 정보는 리플렉션 API를 이용하는데 이는 목(mock)을 이용해서 대치하기가 매우 불편하다. 좀 더 추상화된 인터페이스가 존재해야하는 중요한 이유 중의 하나이다.
마지막으로 현장의 자바환경이 JDK1.5이상으로 변화하는 데에는 아직 몇 년의 시간이 더 필요하다고 보기 때문이다. 그때까지 자바5의 어노테이션을 사용하지 않는 경우에도 메타정보를 활용하는 것이 필요한데 이의 호환을 위해서라도 별도의 추상화된 레이어의 존재가 요구된다.
스프링은 <리스트 7>에 나오는 Attributes라는 인터페이스를 통해서 표준 메타정보를 사용할 수 있도록 정의하고 있다.
이 메소드들의 리턴 값은 오브젝트 형태이다. 따라서 단순한 스프링 정보를 받는 것에 비해서 많은 정보를 담을 수도 있고 클래스 계층구조를 이용하거나 설정 파라미터 값 등으로 활용하는 등의 많은 장점이 있다.
자바5 어노테이션 지원
스프링은 물론 자바5 사용자를 위한 다양하고 편리한 사전에 정의된 어노테이션을 지원한다.
● @Required
Setter 방식의 의존삽입은 생성자 삽입보다 많은 장점이 있다. 하지만 한 가지 결정적인 단점이 있으니 그것은 반드시 필요한 프로퍼티가 삽입되었는지 확인하기가 불편하다는 것이다. 이를 위해서 스프링 빈의 라이프사이클 메소드 등을 이용해서 체크하는 부분을 만들 수 있기는 하지만 번거롭다.
하지만 스프링2.0부터 도입된 @Requred를 사용하면 간단하게 필수 프로퍼티를 지정하고 이를 검증할 수 있다.
<리스트 8>은 movieFinder라는 빈을 필수 프로퍼티로 가지고 있다. 비즈니스 메소드에서 이를 사용해야 하기 때문에 반드시 설정이 되어있어야 한다. 이를 검증하는 기존의 방법은 빈이 InitializingBean 인터페이스를 구현해서
afterPropertiesSet 콜백 메소드를 통해서 검증하는 코드를 일일이 작성해야 한다.
@Required 어노테이션을 사용하면 어노테이션 설정만으로 필요한 프로퍼티가 세팅되었는지를 확인하는 것이 가능하다. 이 적용을 위해서는 RequiredAnnotationBeanPostProcessor를 등록해야한다.
● @Transactional
스프링AOP를 이용한 트랜잭션 설정의 방법 중에서 어노테이션을 이용한 것이 @Transactional 어노테이션이다. XML을 이용한 트랜잭션 설정은 보통 포인트컷 언어를 이용해서 네이밍 룰을 통한 일괄적용을 이용하는 경우가 많다. 그런 방법은 설정이 간결해 질 수 있다는 장점이 있지만 반대로 각각의 빈마다 세밀한 설정을 하는 것이 불편하다.
@Transactional 태그를 이용한 설정은 트랜잭션을 설정할 대상이 되는 클래스나 인터페이스에 간단한 어노테이션만 적용하면 바로 적용할 수 있다. 이를 위해서는 스프링 설정파일에 간단히 를 적용하기만 하면 된다.
디폴트 트랜잭션 설정을 변경하려면 간단히 어노테이션 프로퍼티를 설정하면 된다. Propagation, isolation, readOnly, timeout, rollbackFor, rollbackForClassname, noRollbackFor, noRollbackForClassname을 사용할 수 있다.
@Transactional의 장점은 계층적이면서 오버라이딩이 가능하다는 것이다. 만약 클래스 레벨만 설정했다면 모든 메소드에 동일한 트랜잭션 속성이 적용된다. 그 중 몇 개의 메소드는 다른 설정이 필요하다면 메소드 레벨에 어노테이션을 지정하면 클래스 속성을 오버라이드해서 사용할 수 있다.
반대로 인터페이스에 트랜잭션 어노테이션을 적용했다면 이를 구현한 모든 클래스에도 동일한 트랜잭션 설정이 적용된다. 당연히 오버라이딩하는 것도 가능하다. <리스트 9>는 클래스 레벨의 트랜잭션 설정과 이를 오버라이드한 메소드 설정의 예를 보여준다.
● @Configurable
스프링2.0에서 새롭게 등장한 대표적인 기능이 스프링 빈으로 등록되지 않은 도메인 오브젝트 등에 의존 삽입을 가능하게 하는 것이 있다. 보통 도메인 오브젝트는 new 키워드에 의해서 생성이 되거나 하이버네이트 같은 써드파티 프레임워크에서 생성되어 전달되는 것이 많다.
이런 오브젝트에 스프링의 의존성을 삽입하려면 특별한 기술이 필요하다. 스프링2.0은 이를 위해서 AspectJ의 런타임 위빙과 같은 기술을 적용했다.
만약 User라는 도메인 오브젝트에서 PermissionService라는 서비스 빈을 사용하고 싶다고 하자. 이러기 위해서는 원칙적으로 User 클래스도 빈으로 등록되어야 한다. 하지만 User는 퍼시스턴스 객체로 하이버네이트의 find에 의해서 돌려질 수 있기도 하다. 이런 경우 빈의 등록을 통한 라이프사이클 관리는 불가능하다. 이럴 때 @Configurable을 사용할 수 있다.
<리스트 10>은 @Configurable을 적용한 User 클래스이다. 필요한 의존관계 빈의 Setter가 등록되어있다. 그 다음에 할 일은 @Configurable 어노테이션을 추가하는 것이다. 이 작업만으로 스프링은 이 도메인 오브젝트가 스프링 의존관계 삽입이 필요한 것으로 판단하고 객체의 생성 시점을 가로채서 의존삽입을 진행한다.
어노테이션을 이용한 AspectJ와 스프링의 절묘한 결합이다.
마지막으로 아직은 정식으로 릴리즈 되지 않았지만 스프링2.1에서는 드디어 의존설정 자체를 어노테이션을 통해서 가능하도록 하는 기술이 도입될 예정이다. 이를 이용해서 XML이 없는 스프링 애플리케이션 개발도 가능할 수도 있다.
스프링과 하이버네이트 이외에도 많은 오픈소스 프로젝트들이 적극적으로 어노테이션을 적용하고 있다.
AspectJ는 버전5에서부터 어노테이션 방식의 포인트컷, 조인포인트 설정을 지원하고 있다. 이를 이용하면 단순한 POJO빈을 애스펙트처럼 사용할 수 있다. Junit도 4.x에서는 어노테이션을 활용한 테스트 설정을 지원한다.
기존의 네이밍 룰을 이용한 방식보다 훨씬 직관적이고 편리하게 사용할 수 있다. Google-Guice라는 구글에서 사용하고 있는 최신 IoC 컨테이너도 어노테이션 설정을 주요 강점으로 내세우는 제품이다.
이렇게 많은 오픈소스 기술과 제품들이 앞다투어 소스코드의 어노테이션 기술을 적용하고 있다. 하지만 아직 해결해야 할 몇 가지 문제점들을 가지고 있는 듯 보인다.
아직도 많은 개발자들은 소스코드와 메타정보를 함께 두는 것이 바람직하지 않다는 의견을 가지고 있다. 비록 XML의 설정방법이 더 불편하다고 할지라도 메타정보를 독립시키는 것이 코드와 함께 두는 것보다는 낫다는 주장이다. 어노테이션이나 유사 메타정보 기술의 단점은 그 메타정보가 바뀌었을 때마다 컴파일이 다시 일어나야 한다는 것이다.
따라서 소스가 함께 제공되지 않는 형태의 제품인 경우 어노테이션 사용에 제약이 있다. 단지 기술적인 문제가 아니라 코드와 메타정보의 혼용에 대한 문제제기도 적지 않다. 이런 면에서 아직 어노테이션이 그 편리함에도 불구하고 완전히 메타정보 기술을 평정하고 있지는 않는 듯이 보인다.
게다가 자바의 어노테이션 기술자체에 대한 여러 가지 비판도 제기되고 있다. 결정적인 것은 XML에 비해서 그 정보구성을 검증하는 것이 매우 불편하다는 것이다.
DTD나 스키마(Schema)를 통해서 손쉽게 정보구성을 검증할 수 있는 XML에 반해 어노테이션은 그러한 기술의 지원이 아직은 미비하다. 이를 일일이 코드로 검증하는 것도 사실 개발자들에게는 불편한 작업이 아닐 수 없다.
이런 장단점을 가지고 있는 어노테이션 기술이지만 손쉬운 설정방식이라는 매력 때문인지 그 기술도입은 점점 확대되어 가고 있다. 이를 잘 활용한 오픈소스의 다양한 기술들이 현장에서 검증되는 것을 통해서 다음 버전 자바의 어노테이션 기술이 한층 더 발전할 수 있는 계기가 될 수 있기를 기대해본다. @